AI 对话背后的水电账单
刚才那场对话,你其实每天都在重复:写封邮件,查段资料,随口问一句。每一次,屏幕这头风平浪静;屏幕那头,有电在流动,有水在蒸发——开场右上角那只小量杯,量的正是这个。只是它从不发烫,也不寄来账单,你便很难想起它。
一次对话,到底花掉多少?
2025 年 4 月,有人在社交平台上问:大家对 ChatGPT 说“请”和“谢谢”,会让 OpenAI 多花多少电费?CEO 萨姆·奥尔特曼回了一句——“数千万美元,你永远不知道”。人们下意识中说出的一句客套话,在数亿人口中重复,竟累成了一张真金白银的电费单;据估算,光是回一句“不客气”,也要耗去约 40 到 50 毫升水[1]来给服务器降温。
据加州大学河滨分校估算,让 AI 写一封一百词左右的邮件,背后约消耗 519 毫升水,约等于大半瓶矿泉水;在能效较低的地区,甚至接近三瓶。
OpenAI 与 Epoch AI 最新的估算是,一次提问约耗电 0.34 瓦时,够一盏 10 瓦灯泡亮约 2 分钟;在早些年被广泛引用的研究里,同一盏灯,能亮约 20 分钟,这一估算值是前文数字的近十倍。
两个数都出自认真的测算,却差出一个数量级:模型在换代、问题有长短、各家口径不一,而公司几乎从不公开细账。连“一次提问耗多少电”都没有公认的答案。
单次微不足道,乘起来呢?
可 AI 的故事,从来不在“单次”,而在“乘以多少次”。如今全世界每天向 AI 发出的提问以十亿计,而且还在指数级膨胀[2]。一滴水,乘上这样的倍数,会汇成一条河。
于是问题来了:这条河,究竟有多大?它流向哪里?又落在谁的土地上?
这条河,谁在谈、谁在沉默?
其实,这条河并非无人察觉。我们用 34 组关键词(含中英文同义词),检索了 2023 年 4 月至 2026 年 6 月中外主流媒体的公开报道,经去重与相关性筛选,最终纳入了来自77 家媒体的 1769 篇。而后逐篇统计每个议题出现在多少篇报道里,绘制出如下词云图:
绝大多数中英文报道中都会频繁出现这些关键词:AI、算力、数据中心、电网。“AI/人工智能”出现在 95% 的报道里,“数据中心”“算力”各约 七成,“电网压力/可靠性”近半。不过国内的报道重心是算力产业与治理,国外的报道更喜欢追问AI扩张带来的社会反应。
真正耐人寻味的,是那些声音很小的词。水耗 / 水资源只出现在 224 篇报道里,覆盖度 12.66%,在 34 个议题中排第 26 位,远低于电力主线;“社区影响/反对”也只占 17.9%,且相对更多来自国外;“训练”与“推理/查询”的能耗差异(28.9%、21.1%)很少被拆开来谈;至于供应链矿产、电子废弃物、边际排放,几近缺席(覆盖度 17.9%、0.57%、0.06%)。
综上来看——关于 AI 耗能,我们已经谈了很多“电“,却很少认真算过那笔”水账“,更少追问它究竟落在谁的土地上。
要回答这些,得先打开那个黑箱:这些电和水,到底花在了哪儿。
数据中心的水电账单
把“云”拆开,里面到底是什么?
互联网数据中心(IDC)是提供电子信息集中存储、传输、交换及常规托管的物理基础设施。其内部硬件主要由通用中央处理器(CPU)服务器、固态硬盘(SSD)、机械硬盘(HDD)以及标准网络交换机组成,主要面向网页访问、云存储和企业管理系统提供数据调阅服务。根据美国银行全球研究部(BofA Global Research)发布的报告《Who Makes the Data Center》,数据中心综合建设成本的结构分布,见下方环图(左)。
上述基础设施在实际商业运作中,主要由数据中心服务商(包括基础电信运营商与中立第三方 IDC 厂商)负责投资建造与环境运维。服务商通过向客户租售机柜空间、供电容量及骨干网络带宽来回收资本开支(CAPEX)。受下游用户密度、互联网产业集群以及国家能耗政策的驱动,服务商的资源部署呈现明显的区域聚集性:据 CDCC《2021 年中国数据中心市场报告》,2021 年的存量机柜高度集中在东部沿海与一线城市群——具体分布见下图。
智能算力中心(AIDC)则是面向生成式人工智能模型的训练、推理及深度学习、提供矩阵运算的技术基础设施。其内部硬件以图形处理器(GPU)、张量处理器(TPU)等异构加速芯片构成的加速服务器为主,并配备高性能无损网络与液冷散热系统。根据中证鹏元资信评估《新质生产力系列:全球 AIDC 核心环节的迭代突破》,经等比例换算占总投资的比例,算力中心综合建设成本的结构分布,见下方环图(右)。
- 服务器(CPU 集群)66.5%
- 工程设计与建造10.9%
- 网络设备9.6%
- 供配电系统4.5%
- 暖通空调3.7%
- 存储系统3.2%
- 备用柴油发电机1.6%
- IT 算力设备36.8–51.2%
- 非设备投资(建造/土地)20–30%
- 通信设备9.8–16.0%
- 供配电设备7.7–13.2%
- 散热制冷系统4.9–8.4%
- 管理系统1.4–2.4%
两类基础设施分工不同:传统数据中心容量大、存储成本低,主要负责原始数据的汇聚、沉淀与清洗,充当数据资产库;智能算力中心则是计算引擎,承接这些清洗后的数据进行高速运算。随着产业演进,二者也呈现出融合趋势——存量 IDC 局部向智算化改造、新建 AIDC 向存算一体化发展。它们相互支撑,共同构成了 AI 模型开发的上游基础设施层。
中游的模型研发机构(包括高校科研院所,以及智谱 AI、月之暗面、MiniMax 等国内头部通用大模型厂商)是模型训练的直接执行者:它们提取上游数据中心存储的标准化数据集,在算力中心租用 GPU 计算单元进行分布式并行预训练,最终产出通用基座模型。处于产业链终端的下游科技公司与行业应用开发商,则通过 API 接口直接调用中游的模型能力,或利用自身托管在传统数据中心里的垂直行业数据,对开源模型做二次微调,从而开发出面向终端用户的智能 SaaS 应用与场景化产品。
此外,市场中还存在全产业链垂直一体化的科技巨头(如华为、阿里、腾讯等)。这类公司同时具备超大规模数据与算力中心的建设运营能力,能自主研发并训练基座模型,并直接把 AI 能力部署进自家的公有云、搜索引擎与办公套件。而无论是聚焦特定场景的下游公司,还是全链路自研的巨头,终端用户在使用这些 AI 服务时产生的增量数据,最终都会再次回流至传统数据中心进行存储与清洗。
一座数据中心,一年要喝掉多少水电?
要谈消耗,先看体量。撑起这一切的,是一个正在爆发式生长的庞然大物:数据中心。
衡量它的一把新尺子,叫“token”——AI 处理信息的基本单位。仅谷歌一家,每月处理的 token 就从 2024 年 5 月的 9.7 万亿,涨到 2026 年 5 月的 3200 万亿[3],两年约 330 倍;它的接口每分钟要吞下约 190 亿个 token。需求的洪水,需要海量的机器来接住。
于是机器在疯狂建起。到 2024 年,中国在用的数据中心标准机架已超 880 万架[4],总算力达 246 EFLOPS[5](工信部口径,截至 2024 年三季度;ExaFLOPS,即每秒百亿亿次浮点运算、约 1018 次/秒);东数西算八大枢纽,带动投资已超过 2000 亿元。而这一切都要靠电来喂:2024 年,全球数据中心耗电约 415 太瓦时[6],占全球用电约 1.5%,其中中国约占四分之一;到 2030 年,这个数字预计翻倍到约 945 太瓦时——多出来的,几乎相当于再添一个日本的全年用电。
这么多电,并非都用来“算”。一座机房的用电,大约一半或更多用于 IT 设备的运转,其余很大一部分,用于冷却散热——而冷却,正是水蒸发的地方。
这个比例由能效(PUE)决定:越老旧低能效的机房,冷却吃掉的电越多。反过来,把机房放到气候干冷的地方,光靠自然风就能散热。以一座西北沙漠小城——宁夏中卫为例:干燥凉爽,当地数据中心用全自然风冷,把冷却压到极低。这也是大批算力扎进西部干冷地区的原因。
还有一个反直觉的事实:很多人以为训练一个大模型最耗能。可训练通常只做一次,而推理——也就是你我每一次提问——却日复一日地重复。把模型的一生算下来,推理才是大头。
那水呢?没有逐年公开的全国用水数,不等于算不出来。电是被年年数得清清楚楚的,而每一度电背后要蒸发多少水,是有系数的。这种换算的方式,能在一定程度上补齐前文缺口。
—— 北京理工大学“能-水”预测模型给出的全国宏观水足迹强度
1500 亿度 × 0.5
750 × 66.7%
750 × 25%
那么,这 1700 亿度电,究竟是什么概念?
把前面拆开的电与水合到同一张图上,一座数据中心的“水电去向”就一目了然了——最左是来源,中间是各项用途,最右是它们最终的归宿:
它不只是机房,而是一整套系统。
“云”这个词,太轻了。它让我们以为 AI 没有重量、没有地点、没有代价。但实际上,它背后藏着的是一整个层层嵌套的系统。
首先是芯片。制造一块芯片,大约要用掉 30 升水;一座晶圆厂,每天要用约 3800 万升超纯水,相当于约三十万人一天的生活用水——机器还没开机,就已经渴过一轮。
再往下,是机房、是水、是电、是土地,是维系它运转的人力,是调度这一切的资本与国家政策。学者凯特·克劳福德把这称作要“破除 AI 技术中立的神话”——AI 从来不是纯技术,而是一种组织资源、行使权力的方式。
这套系统越往上越显眼,越往下越不可见。上面的每一层,都压在下面那一层之上;抽掉任意一层,这套系统都难以正常运行。
而包括水和电在内的能源,恰好是承重的中间一层。它连接最底下的矿石、土地和最上面的算力技术。下面这张图,直观展示了以云为核心的这套系统:”
把镜头拉远——这样的机器,正在中国的版图上,涌向一个出人意料的方向。
算力的跨区域配置
算力为何要从东部,搬向西部?
把镜头再拉远到全国。所谓 “东数西算”,是用一张统一的算力网络,把东部旺盛的算力需求,有序地引导到西部去“算”——优化数据中心的全国布局,让东西部协同起来。
国家发改委把它定位为一项国家级的算力资源跨域调配工程:我国算力总体上“东部不足、西部过剩”,于是引导中西部凭借能源优势建设算力底座,承接东部沿海等紧缺地区的需求。到目前,工程已在京津冀、长三角、粤港澳大湾区、成渝,与西部的内蒙古、贵州、甘肃、宁夏——共 8 地——布局国家算力枢纽节点,并配套 10 个国家数据中心集群。下面这张图,就是算力“向西”的散点轨迹:
这八个枢纽,在地图上是八个光点;落到地面,则是八组真实的厂房:
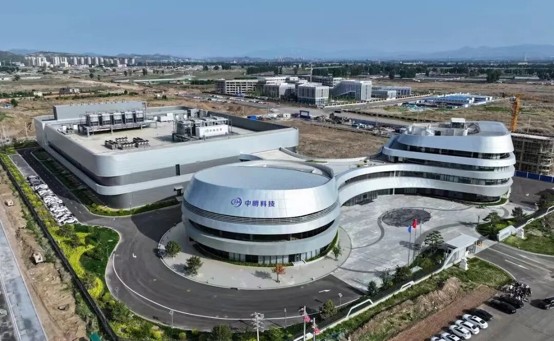
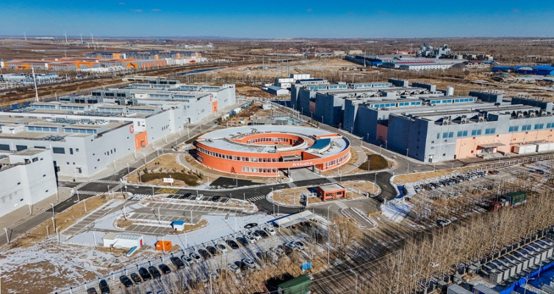
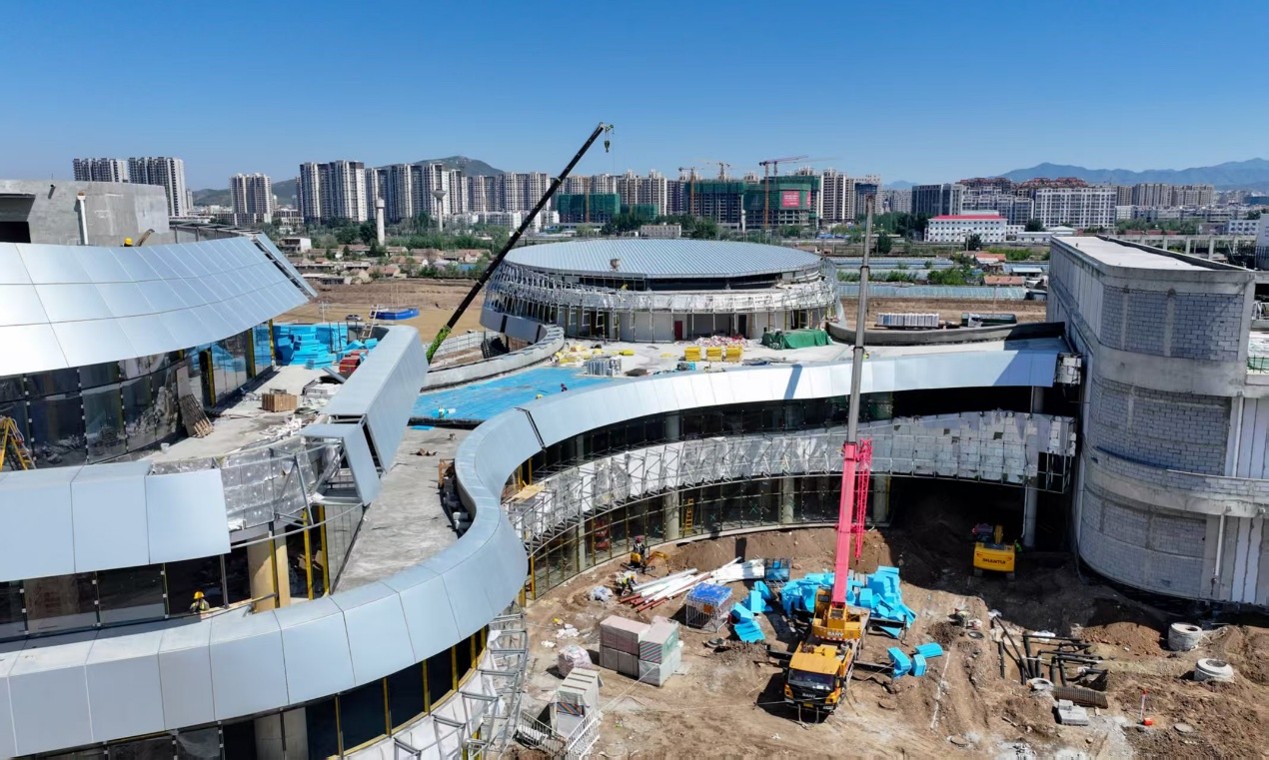
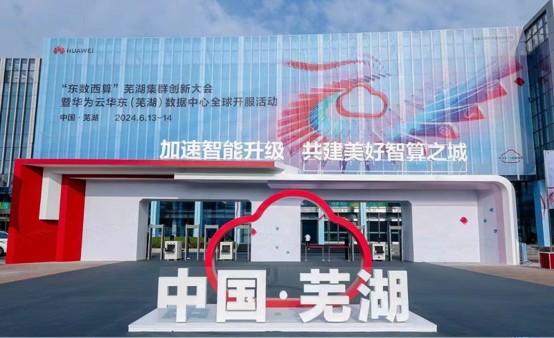
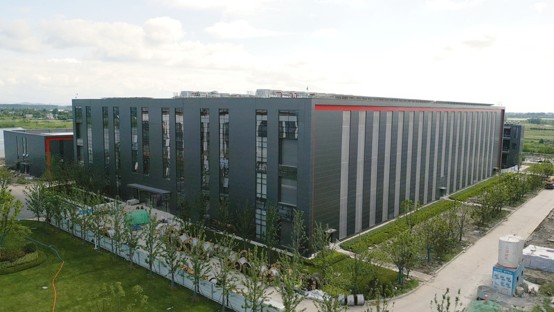
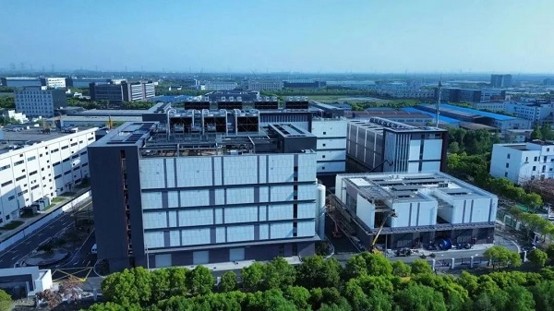
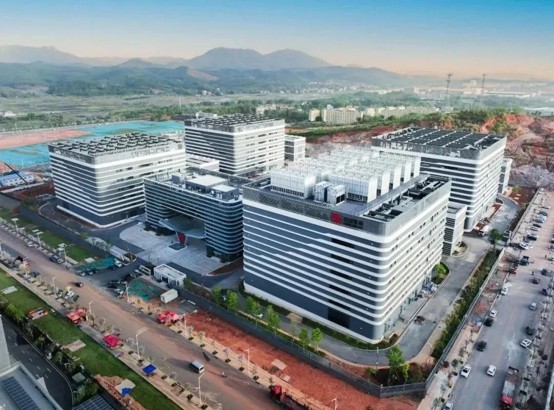
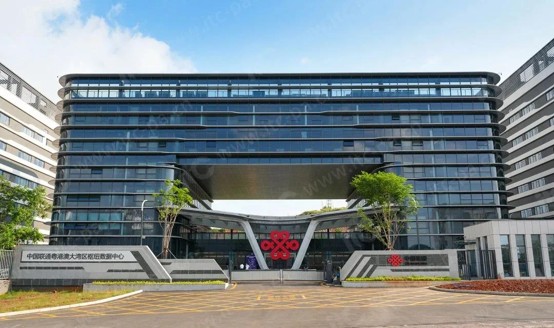
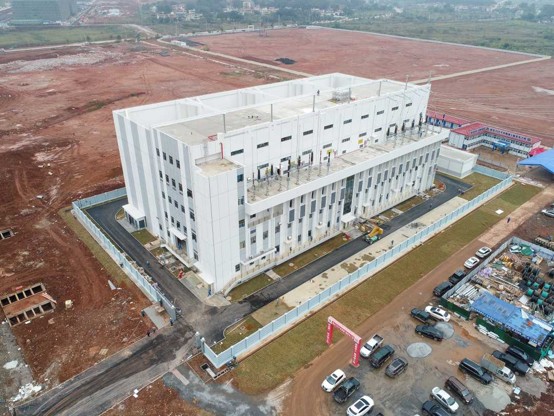
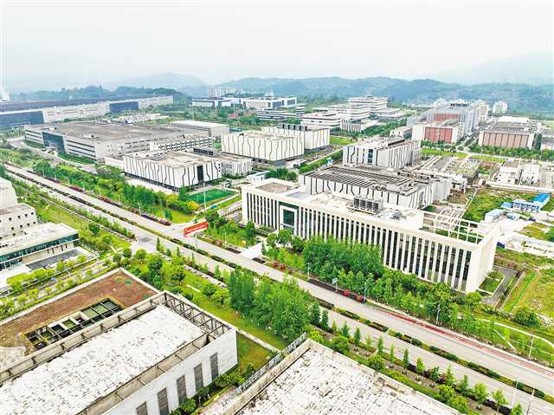
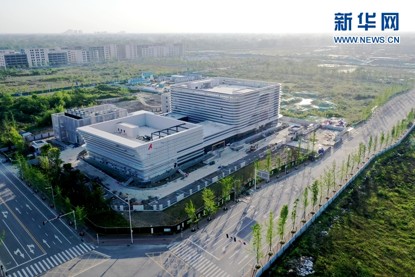
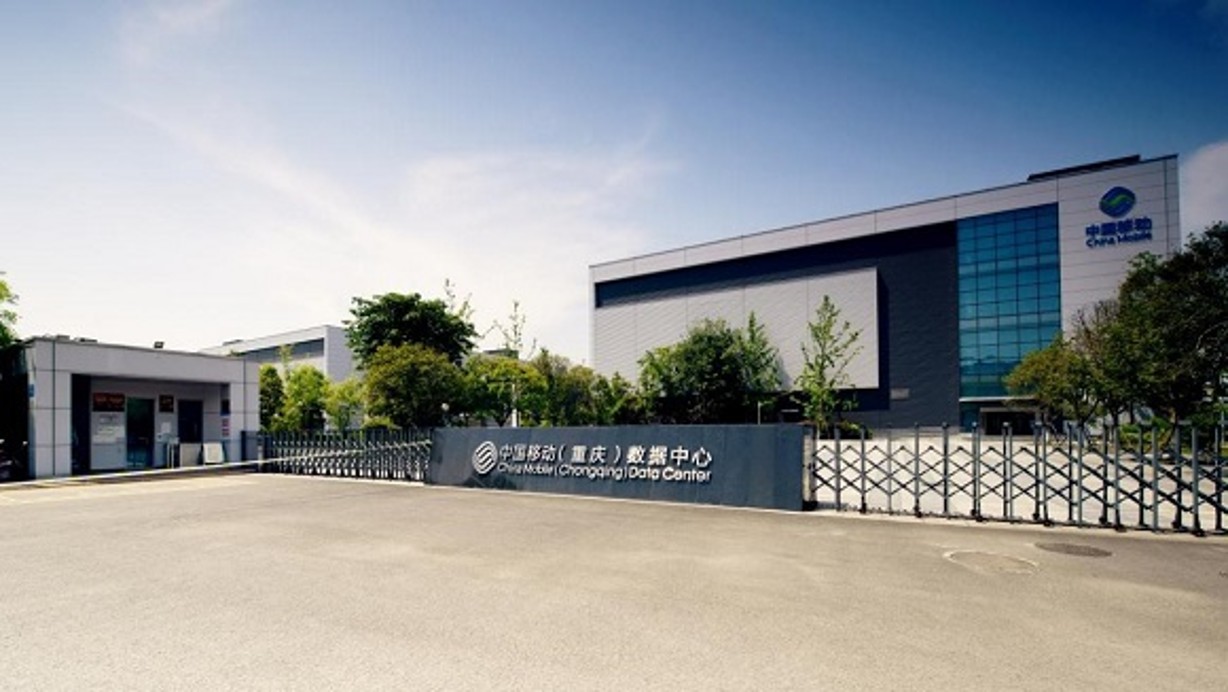
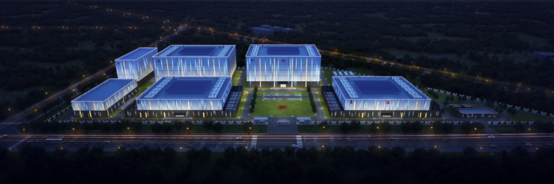
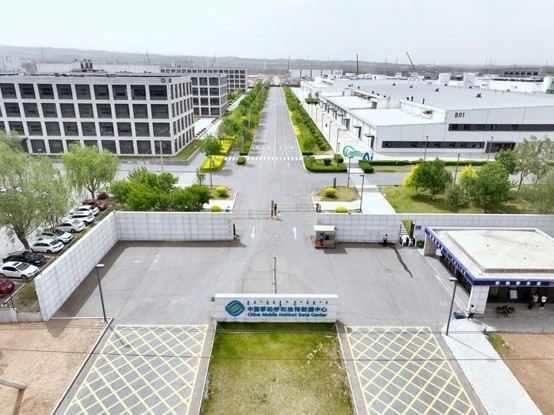
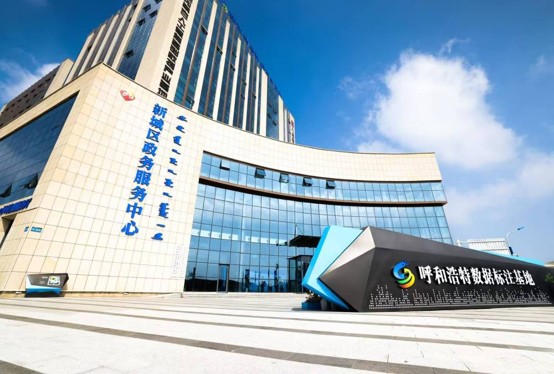
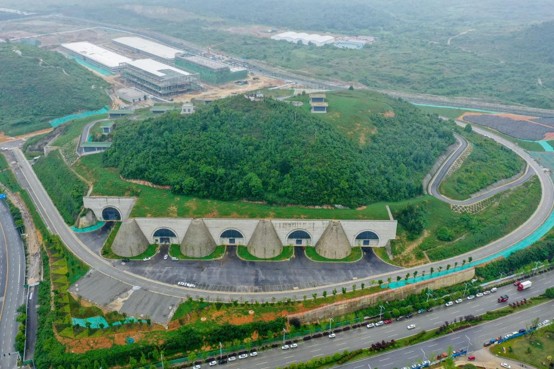
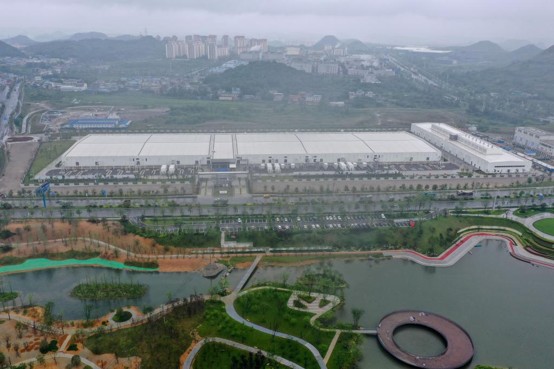
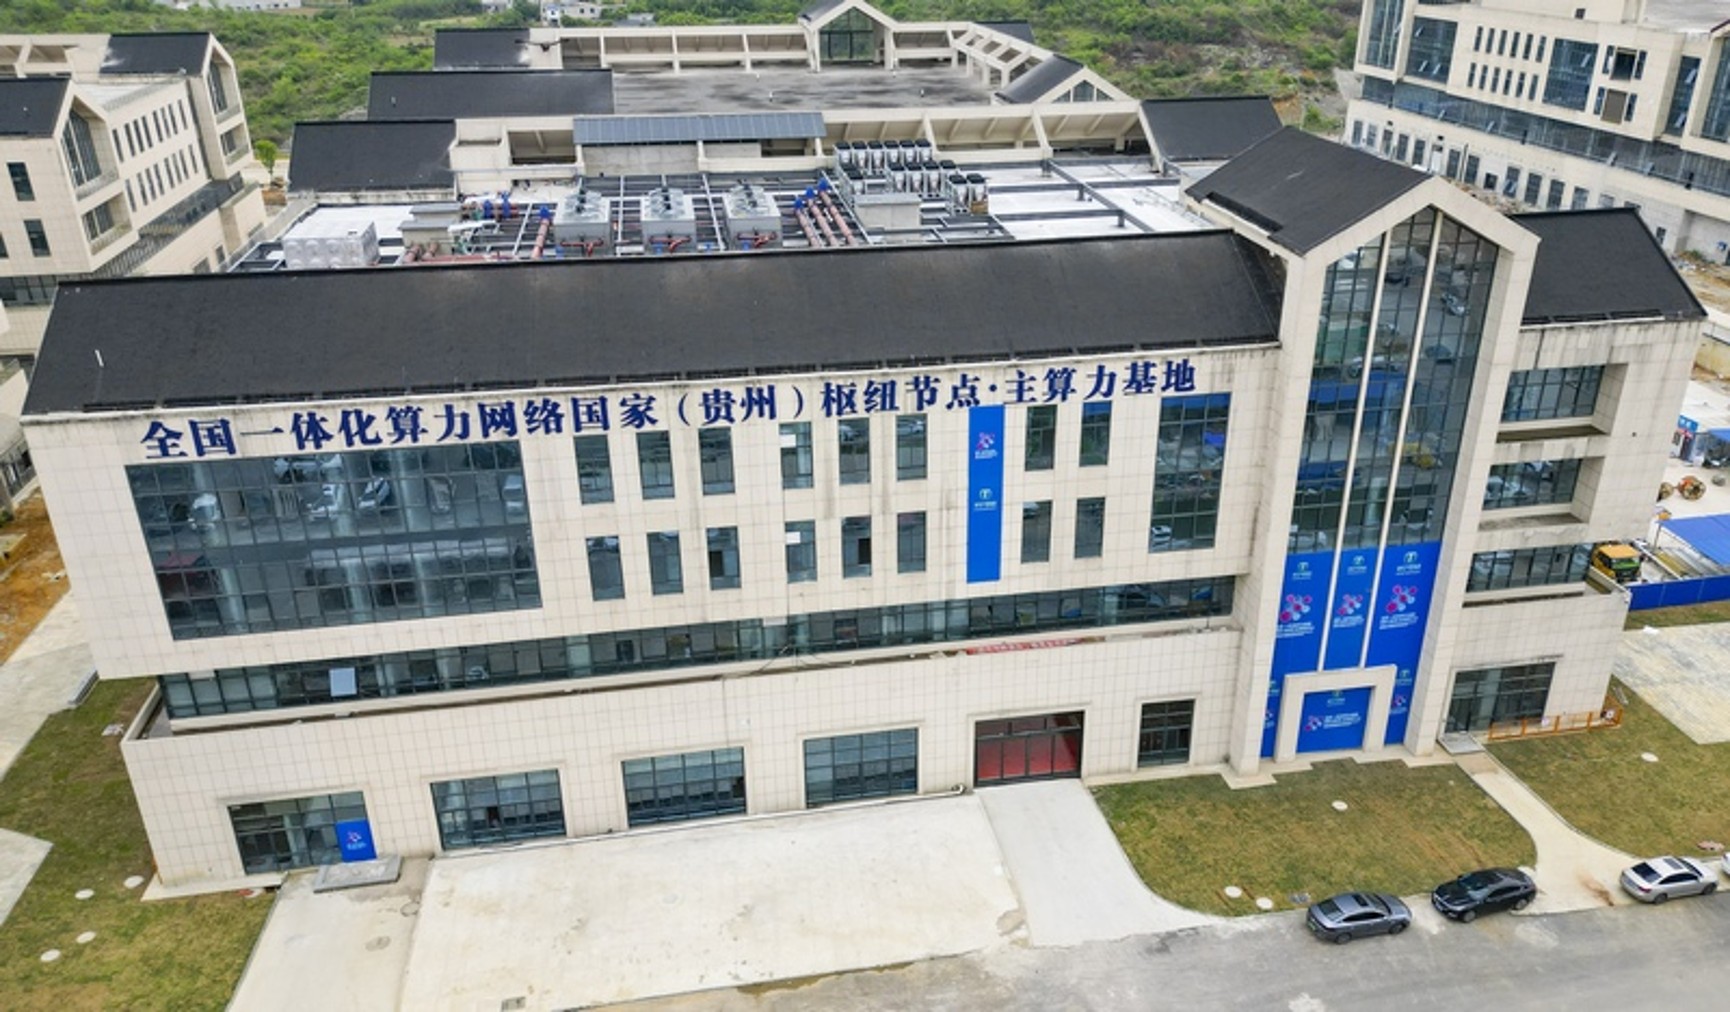
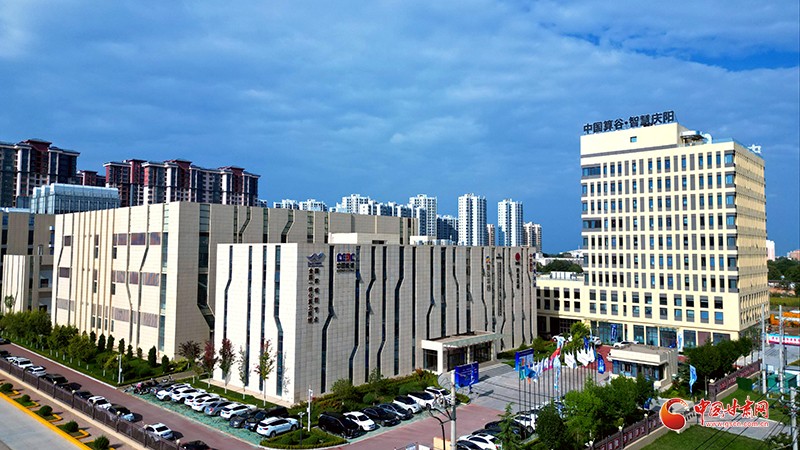
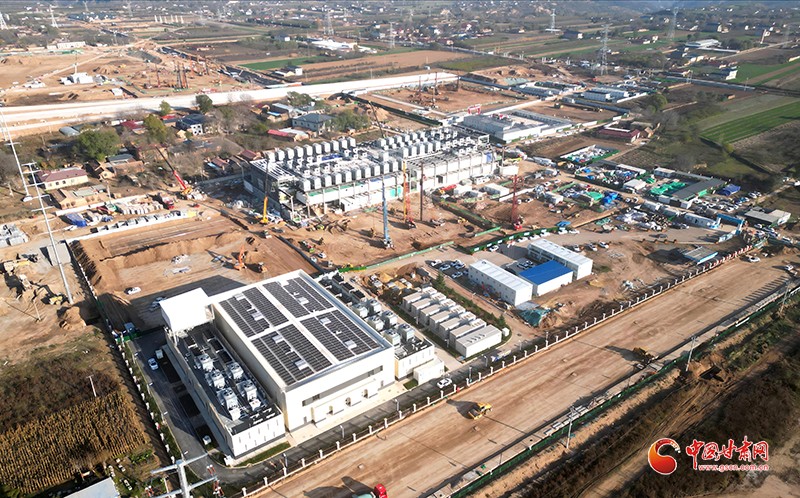
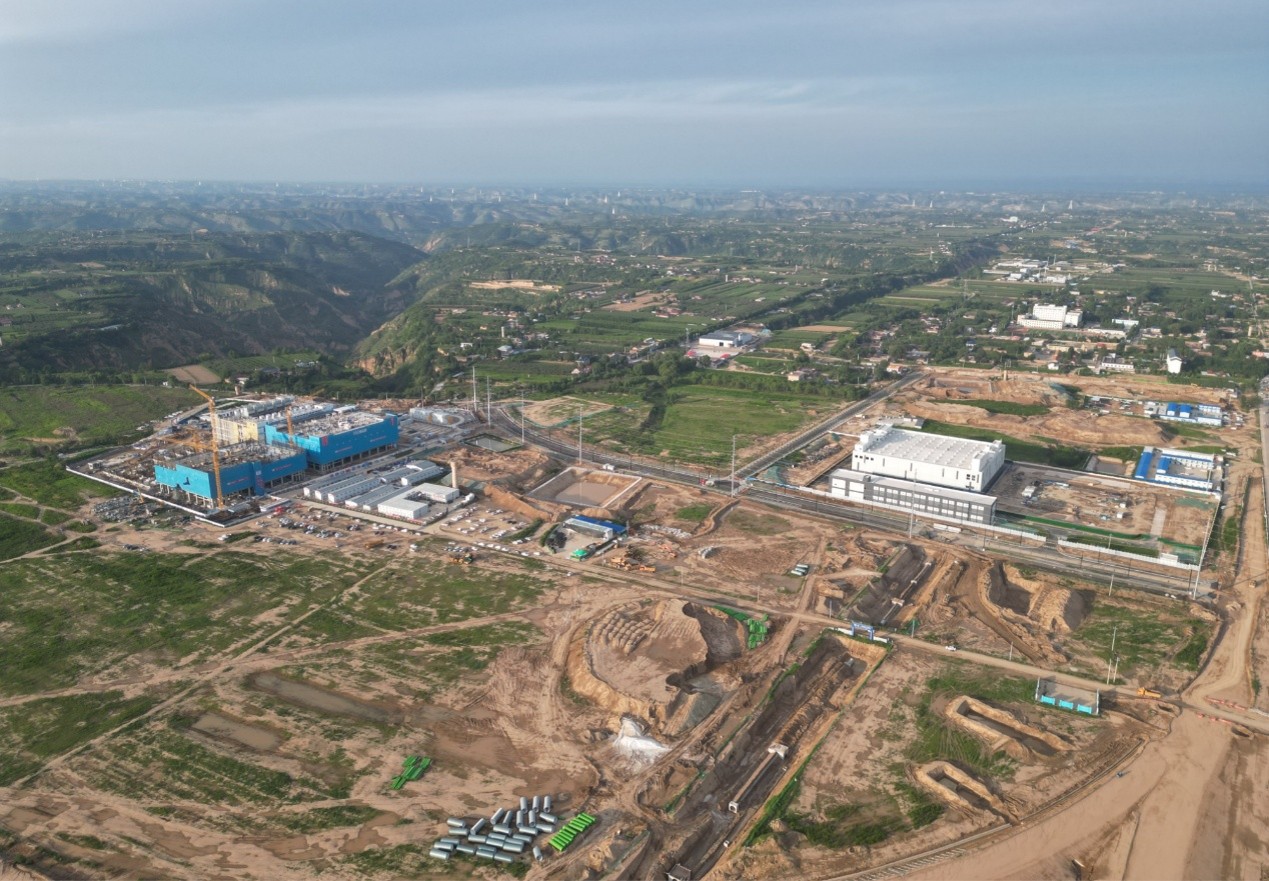
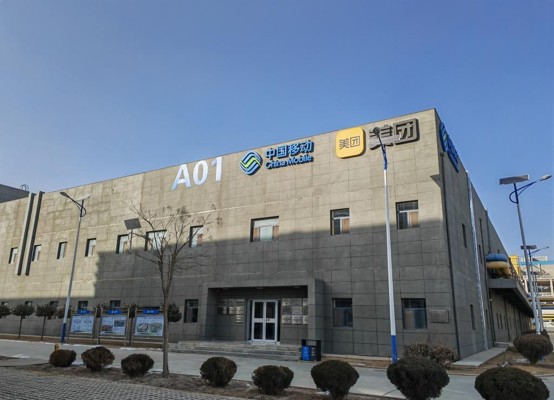
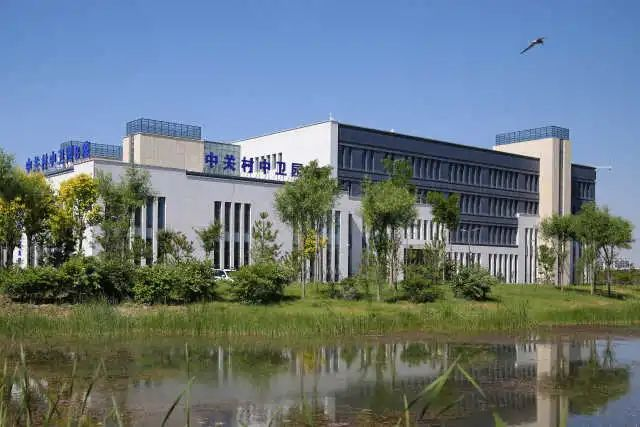
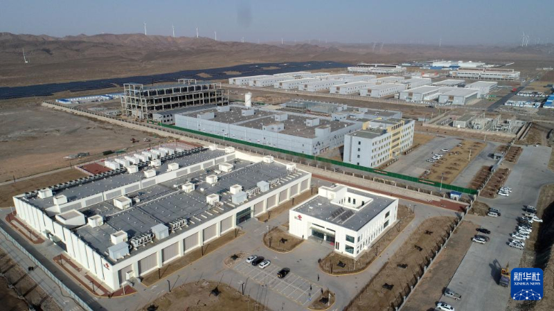
这项工程是逐渐展开的。从2020年的一纸通知,到如今的国家级工程落地,六年间政府持续出台文件推动着这一进程。以下为政策时间线:
明知缺水,为何还要往西建?
要回答这个问题,得回到水和电。数据中心是不折不扣的能耗巨兽,电力占了运营成本的 56.7%,冷却的耗水同样惊人。而在东部,这样一封账单已逼近极限——按各枢纽所在地 2025 年的发用电对比,京津冀、江浙沪、粤港澳的电力供应都有缺口,其中江苏、浙江、广东最大,分别达 2458、2349、2495 亿千瓦时;京津冀人均水资源量更不足 230 m³,仅为全国平均的一成,远低于国际公认的 500 m³ 极度缺水线。压力之下,2026 年起,北京对 PUE 超过 1.35 的数据中心开征差别电价,门槛越收越紧。
反观西部,优势恰好补上了东部的短板:内蒙古 2025 年底新能源装机达 1.54 亿千瓦、居全国第一,和林格尔集群绿电直供到户电价低至 0.36 元/度,约比北京便宜三分之二;贵州贵安年均 15℃ 的气温,让华为云数据中心的 PUE 低到 1.12,满负荷一年省电约 10 亿度。把高耗能、又不追求实时的 AI 训练与离线分析迁往这里,既省钱,又省下长途输电的损耗。
于是算力一路向西。但这套精打细算里,藏着一笔没被算进去的代价——水。被引向西部和北部的算力,扑向了风、光、煤富集之地,而那里,往往也最缺水。
而西部的水,本就经不起这样的索取。据标普全球 2026 年的数据,西部地下水超采区面积同比扩大 12%,西北干旱区数据中心的水耗强度是东部的 1.8 倍——更依赖蒸发冷却,单位算力反而更费水。2026 年,全球 AI 数据中心的直接用水预计突破 38 亿立方米,而间接用水(发电耗水)更是直接用水的 6 至 8 倍。算力西迁,用数据输送替代了电力长途输送,却替代不了水的真实消耗——西部的算力优势与水耗困境同时存在。
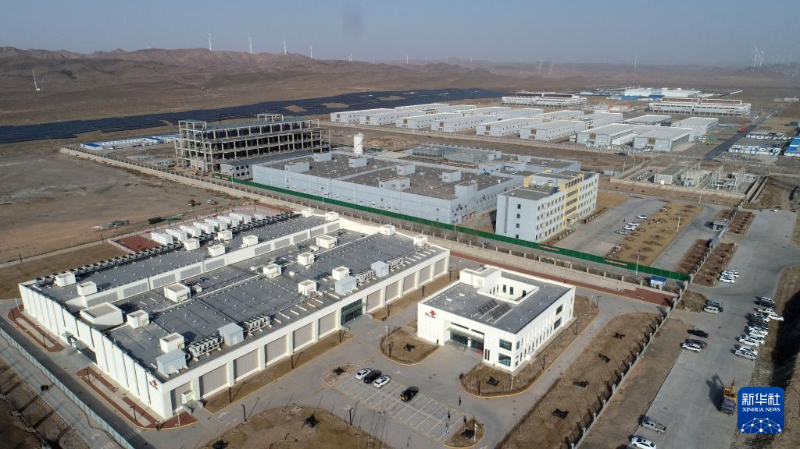
以宁夏中卫为例。2025 年用电 14.38 亿千瓦时、同比增长 47%,2026 年 5 月用电负荷突破 31.35 万千瓦、同比翻倍;25.6 万架标准机架、23.13 万 P 算力,多家科技公司相继入驻。驱动这一切的,是它年均 8.8℃ 的干冷气候——机房几乎全年风冷,PUE 能低至 1.1;加上 0.36 元/千瓦时的到户电价、约只有东部的 45%。风冷省电、绿电降碳、电价洼地,把算力一点点吸了过来。
但它也落在了全国最缺水的土地上。中卫年降水仅 180 毫米,蒸发量却高达 1914 毫米;就在其一个片区,规划的年用水量便达 1705 万吨——约等于 36.8 万人一年的生活用水。而若这些电烧的是煤,发电环节蒸发的水,几乎和机房现场用掉的一样多。便宜的电,其实是用昂贵的水换来的;产值流向了别处,沉重的水账单,却留在了当地。
明知缺水,为什么还要建?
答案不在中卫,而在更大的结构性矛盾里:算力需求在指数级增长,东部电网的扩容却跟不上;而西部,尚有承载空间。算力枢纽的本质,是把西部的能源优势转化为数字资产,再以光纤输送全国——在全国层面完成一次“能源换产值”的区域再平衡,把资源消耗做空间上的再分配。让水耗留在水资源还有弹性的西部,让高附加值的数据服务留在东部,已是当下能做到的最优解。
何况算力也在反哺西部。到 2024 年底,中卫已注册落地企业 452 家、累计投资 417 亿元;2025 年,信息传输等行业的投资增速高达 126.8%,对全市投资的贡献率达 46.2%。一座西北小城的经济命运,已经和这套庞大的系统牢牢绑在了一起。
于是,算力、投资与一座城的经济命运,绑成了一台停不下来的飞轮——它越转越快,也越来越难停下来:
账单,寄给了谁
收益与代价,落在了不同的地方。
这一幕要追问的,是另一件事——这张水电账单,到底寄给了谁?它从不只寄给屏幕前提问的人。
2023 年,谷歌计划在乌拉圭卡内洛内斯省建一座数据中心,设计每秒抽水 228 升、年耗水约 70 亿升——是其智利数据中心的七倍;而当时乌拉圭正经历七十多年来最严重的干旱,政府一度往自来水里掺海水应急。抗议者喊出的口号是:“这不是旱灾,是掠夺”。项目后来被迫改用风冷,可每年仍排放约 2.5 万吨温室气体。
同样的剧本在多地上演。墨西哥克雷塔罗州已运行 10 座数据中心、还要再建 18 座,其中一些专为 ChatGPT 服务;牛津学者瓦尔迪维亚记录下当地原住民胡安的处境——每天来回步行四小时去打水,而数据中心却在抽取饮用水,为服务器降温。
在智利,谷歌于圣地亚哥郊区基利库拉建起拉美第一座超大规模数据中心,获准在长达十四年的特大干旱中、每秒从含水层抽水 50 升;当它提议再建一座、每秒抽 169 升时,被当地社区成功抵制,2024 年环境法庭裁定叫停。但更多项目,在社区还来不及组织时就已获批。水被抽走,代价却留给当地人——这从来是一道关于分配与不平等的题。
账单不只写在水里,也写在电价里。爱尔兰是欧洲数据中心密度最高的国家:2024 年,数据中心吃掉了全国 22% 的电,比所有城市家庭用电之和(18%)还多。地球之友委托的研究测算,2015–2023 年数据中心的电力需求,累计让每个家庭多付了约 360 欧元电费,全国合计 7.15 亿欧元;若政策不变,未来十年每户还要再多付数百欧元。有议员点破其中的结构:家庭支付的电网费,是数据中心的六到八倍——研究者称,这等于爱尔兰家庭一直在缴一笔“隐形的数据中心税”,而它“是政治决策的结果”。
也有地方已经动手。荷兰 2019 年冻结阿姆斯特丹都会区的数据中心建设,2022 年进一步在全国叫停新建超大规模数据中心。冻结之前,开发商在商业区几乎不经审查就能拿到许可,哪怕电网早已过载;冻结之后,运营商开始共享线路、错峰用电,电价降幅一度高达 65%,电网接入第一次成了选址的首要考量。约束之下,一种新的运营纪律被逼了出来。
这些选择背后,能拍板的从来不是孤立的个人,而是制度。
问题从来不在“向西”这个方向,而在于:当前的制度,只把电算进了成本,没把水算进去。发改委已经用文号,把 PUE 和绿电的硬指标钉死;可水,还没有一把同等的尺子——企业的水数据多靠自愿披露,横向不可比、纵向易反复。能被量化、能写进 ESG、能变成公关素材的,进步最快;难以标准化的,就留在了灰色地带。这与全球的图景一致:那笔水账,被有意无意地放在了一边。
说到底,每个国家都在答同一道制度选择题——区别只在于,把哪一笔账算进了成本,又把哪一笔,留给了当地的河流与居民。
面对这种错配,已经有哪些努力?
面对这种错配,改变并非没有发生。在国家层面,“东数西算”正从一个个园区的建设,升级为全国一体化算力网的统筹调度——《实施意见》要求到 2025 年底,枢纽节点新增算力占全国六成以上、新建数据中心绿电占比超八成,并把 PUE、WUE、CUE(电、水、碳的利用效率)写进治理语言,推广液冷、探索海洋与山洞等自然冷源;2026 年又试水“算力券”“算力超市”,想让中小企业和承压地区也能分到算力红利,而不是只由头部平台与核心城市独享。
企业这一端,水开始被重新放回责任表。微软承诺到 2030 年实现 “water positive”(补回的水多于消耗),谷歌则提出到 2030 年平均补回数据中心与办公室耗水量的 120%——尽管它 2023 年实际补回的约 10 亿加仑,还只相当于当年消耗的 18%。制度这一端,透明披露也在推进:欧盟依据能效指令(授权条例 EU/2024/1364)建立数据中心能耗与水足迹的强制披露机制,把藏在“云服务”一词背后的影响,变成可被公众和监管比较、追问的数据。
但最关键的一条,或许是承压地区能不能说“不”。技术能压低消耗、调度能优化布局,可真正的公平,还需要受影响的社区拥有要求补偿、要求公开、乃至叫停项目的权利——前面智利环境法庭让谷歌项目重新评估用水,正是这种权利的一次行使。
把算力搬到地球之外,可行吗?
把算力推向西部,是在地球表面重新安排;还有人把目光投向了更远的地方——地球之外。
所谓太空算力,不是把机房原样搬上天,而是把计算能力部署到卫星、星座乃至轨道数据中心,让一部分数据直接在天上处理。它有两种形态:一是 “星上计算”,遥感、通信卫星带上更强的 AI 芯片,在轨完成识别、筛选与决策;二是更远期的 “空间数据中心”,在轨道上部署大规模算力,靠太阳能供电、用光通信与地面相连。现实里已有样本:据新华社报道,2025 年 5 月,“三体计算星座”首批 12 颗计算卫星入轨,把单星算力从 T 级提到 P 级、搭载 80 亿参数的天基模型;欧盟资助的 ASCEND 项目则在论证,能否把数据中心搬到轨道上,用太空太阳能供电、借真空冷环境散热——不再需要水冷。
它之所以被认真对待,正因为地面的边界越来越硬:电力、土地、水与冷却同时收紧,而轨道上有充足光照与天然冷背景;何况遥感、气象、灾害监测的数据本就产生在天上,在轨先筛一遍、只把有用的传回,既省带宽又抢时效;太空算力还被赋予数字主权与韧性的意味——一种不完全依赖地面电网与水土的基础设施。从中国的“三体计算星座”到欧洲的 ASCEND,它已从科幻叙事,走进了可行性研究与组网示范。
这条赛道上,中国起步早、落子快,被认为是全球首个实现太空计算星座在轨组网的国家:从北邮「天算星座」试验,到 2025 年「三体计算星座」首发、通义千问大模型上轨完成在轨推理,再到北京提出建设单座约 1 GW 的太空数据中心。海外巨头也在 2025 年底密集入场——英伟达 Starcloud、谷歌「太阳捕手」、SpaceX 与亚马逊各下注码,技术路线大致分为集中式太空数据中心、分布式计算星座与通信星座扩展三派。具体节点见下面的时间线。
- 2020北邮「天算星座」试验平台启动
- 2025.5「三体计算星座」首发 12 颗 · 全球首个在轨组网
- 2025.11英伟达×Starcloud 送 H100 上轨;谷歌「太阳捕手」启动
- 2025.11通义千问 Qwen3 上轨 · 全球首次大模型在轨推理
- 2025.11北京披露 1GW 太空数据中心规划 ·「辰光一号」待发
- 2026.1SpaceX 拟在星链上叠加算力
- 2030目标:太空算力达 40 万 P ≈ 我国地面数据中心总和
但它远不是万能解。把算力真正搬上天,业内把难处讲得很清楚,主要是四道坎:
真空里没有空气对流,只能靠辐射散热;性能越强,卫星越要增大体积来兼顾算力与散热。
太阳能看似「无限」却难收集:天基算力迈向 10 万 POPS 时功耗将达兆瓦级,而当下卫星太阳翼仅三四十 m²、输出千瓦级,需在轨展开平方千米级的柔性太阳翼。
规模化最大的制约:我国当前约 5 万元/公斤,2026 年有望降到 2.5 万元/公斤,但距规模化所需的 0.5 万元/公斤仍远。
抗辐射芯片可靠性、星间通信、在轨运维、商业模式……一连串问题都还待破题。
更何况,真正的气候收益还取决于全生命周期核算,尤其取决于火箭是否足够低碳;发射排放、空间碎片、轨道占用与空间治理,也都是新的难题。换句话说,太空算力或许能缓解地面的水电之渴,却可能把不平等,从地理空间转移到轨道资源、发射能力与技术主权之上。
无论算力落在西部的戈壁,还是地球之外的轨道,真正要追问的,始终是同一个问题:谁得到智能化的收益,谁承担能源、水、土地与环境的风险,谁又有权参与这场分配。
AI 的进程不会停下,模型只会更大、更快、更无处不在。可每一次看似轻盈的云端调用,都要落回这片土地的水与电上。当我们越来越习惯向 AI 提问,或许也该把一个问题留给自己——在奔向更高智能的途中,我们是否还记得:云,一直在喝水。